Dream Mode:AI 也需要「睡一觉,把白天的事整理好」
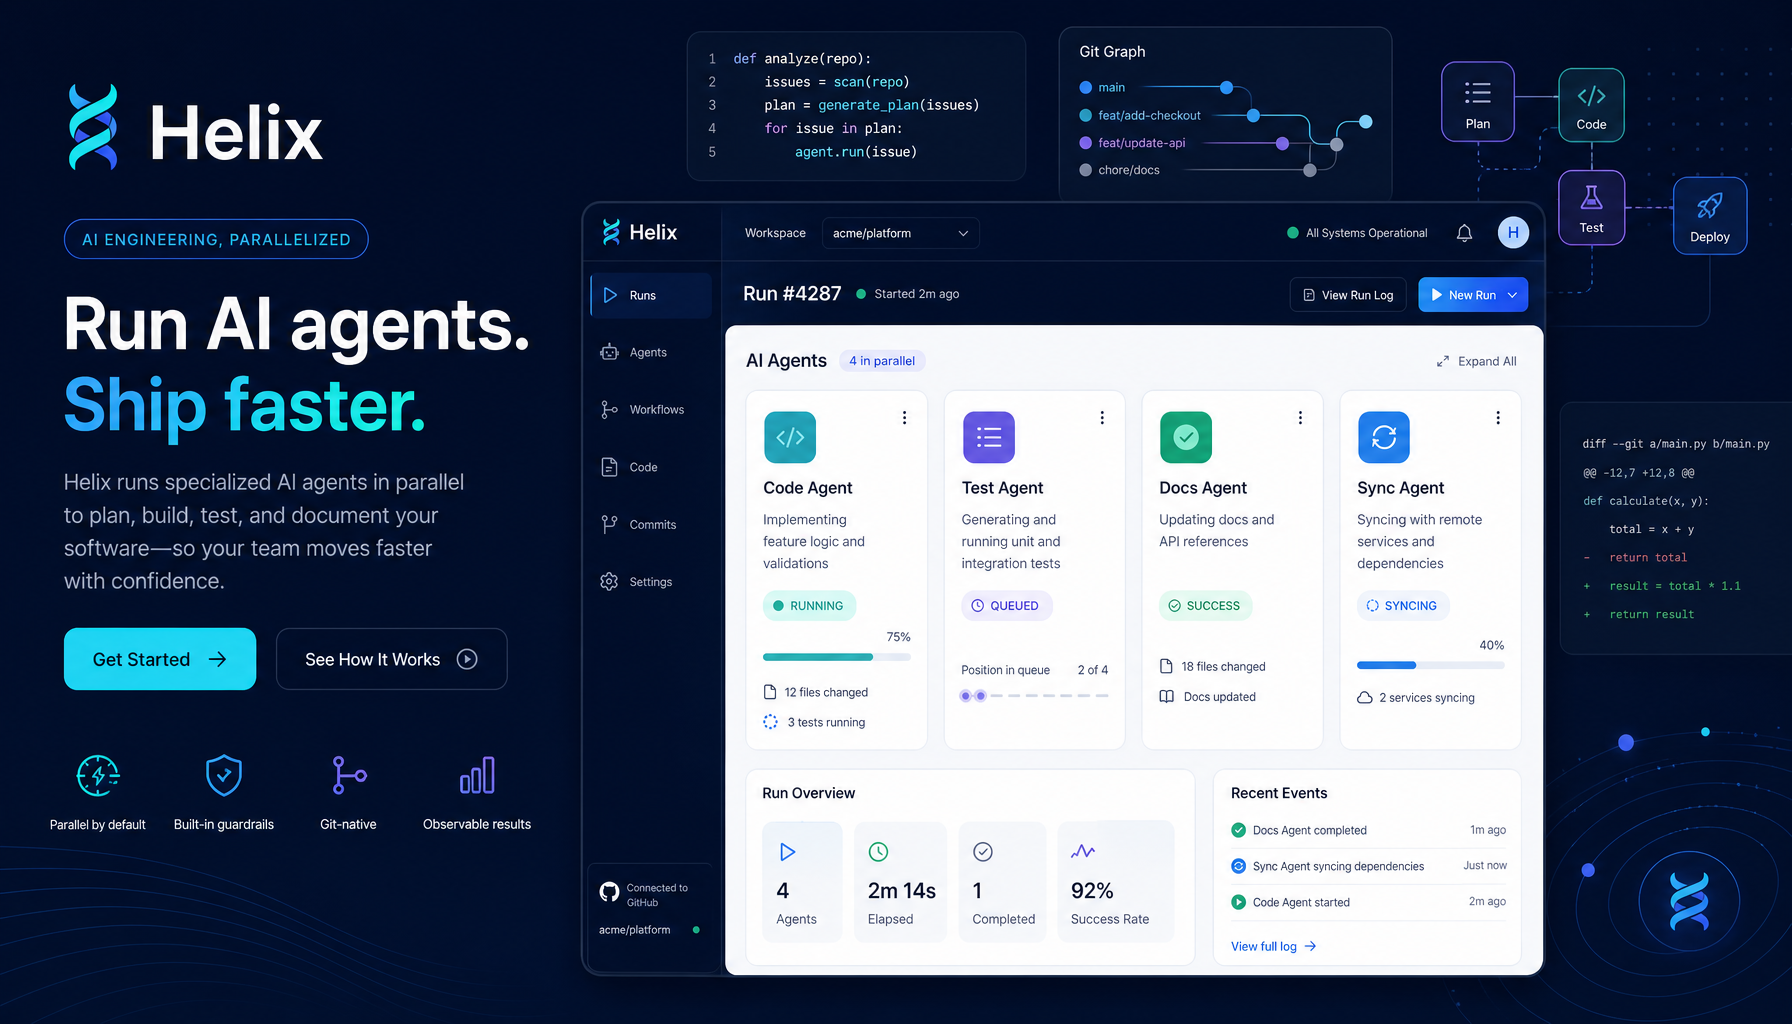
Helix 的标语是「与你共同进化的 AI 伙伴」。但很长一段时间里,我心里清楚这句话只兑现了一半。
「进化」意味着什么?意味着它应该越用越懂你。可真实体验往往是:你今天教它的东西,明天它就忘了。
你告诉它「这个项目的发布流程是先更新 changelog」,它记住了,把任务完成得很漂亮。第二天你开一个新会话,它又像个第一天上班的新人,连你的代码风格都要重新摸索。
问题出在哪?不是模型不够聪明,而是会话结束之后,什么都没有沉淀下来。
Helix 的标语是「与你共同进化的 AI 伙伴」。但很长一段时间里,我心里清楚这句话只兑现了一半。
「进化」意味着什么?意味着它应该越用越懂你。可真实体验往往是:你今天教它的东西,明天它就忘了。
你告诉它「这个项目的发布流程是先更新 changelog」,它记住了,把任务完成得很漂亮。第二天你开一个新会话,它又像个第一天上班的新人,连你的代码风格都要重新摸索。
问题出在哪?不是模型不够聪明,而是会话结束之后,什么都没有沉淀下来。
AI Agent 真正开始接手工程任务之后,有一个问题会越来越难回避:
你的代码、你的会话、你的提示词,到底存在哪里?
当 Agent 只是偶尔帮你写一段代码时,这个问题无关紧要。但当 Agent 开始连续工作几小时、读写你的真实代码库、记住你的项目约定和用户偏好时,「数据主权」就从合规部门的术语,变成了每个开发者的日常关切。
自托管不是「不信任云」的偏执,而是「我的数据应该由我控制」的朴素要求。
Helix 的定位一直很直接:Agent 运行在你的机器上,连接方式由你的场景决定。 今天我想聊聊支撑这件事的三条路:本地直连、自托管隧道、VPN 组网。
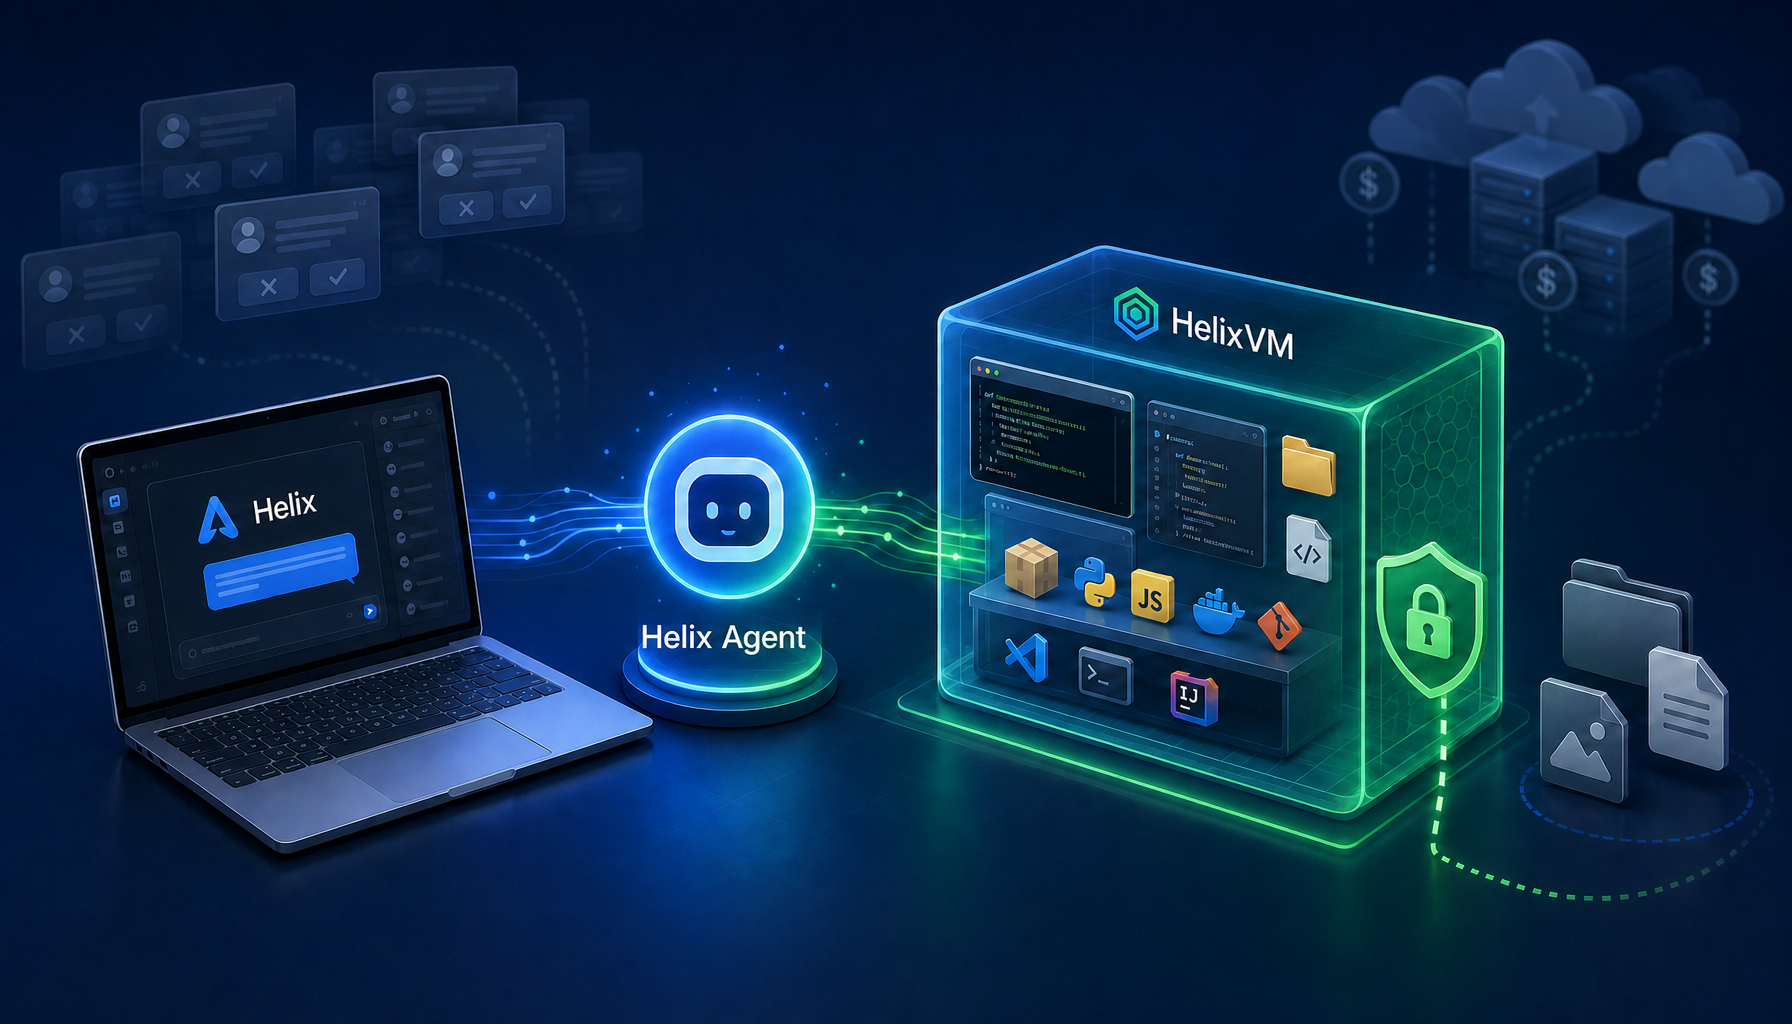
AI Agent 真正卡住普及的,不只是模型能力,而是权限与安全的矛盾。HelixVM 想解决的,就是让 Agent 高效做事,同时不伤到你的真实电脑。


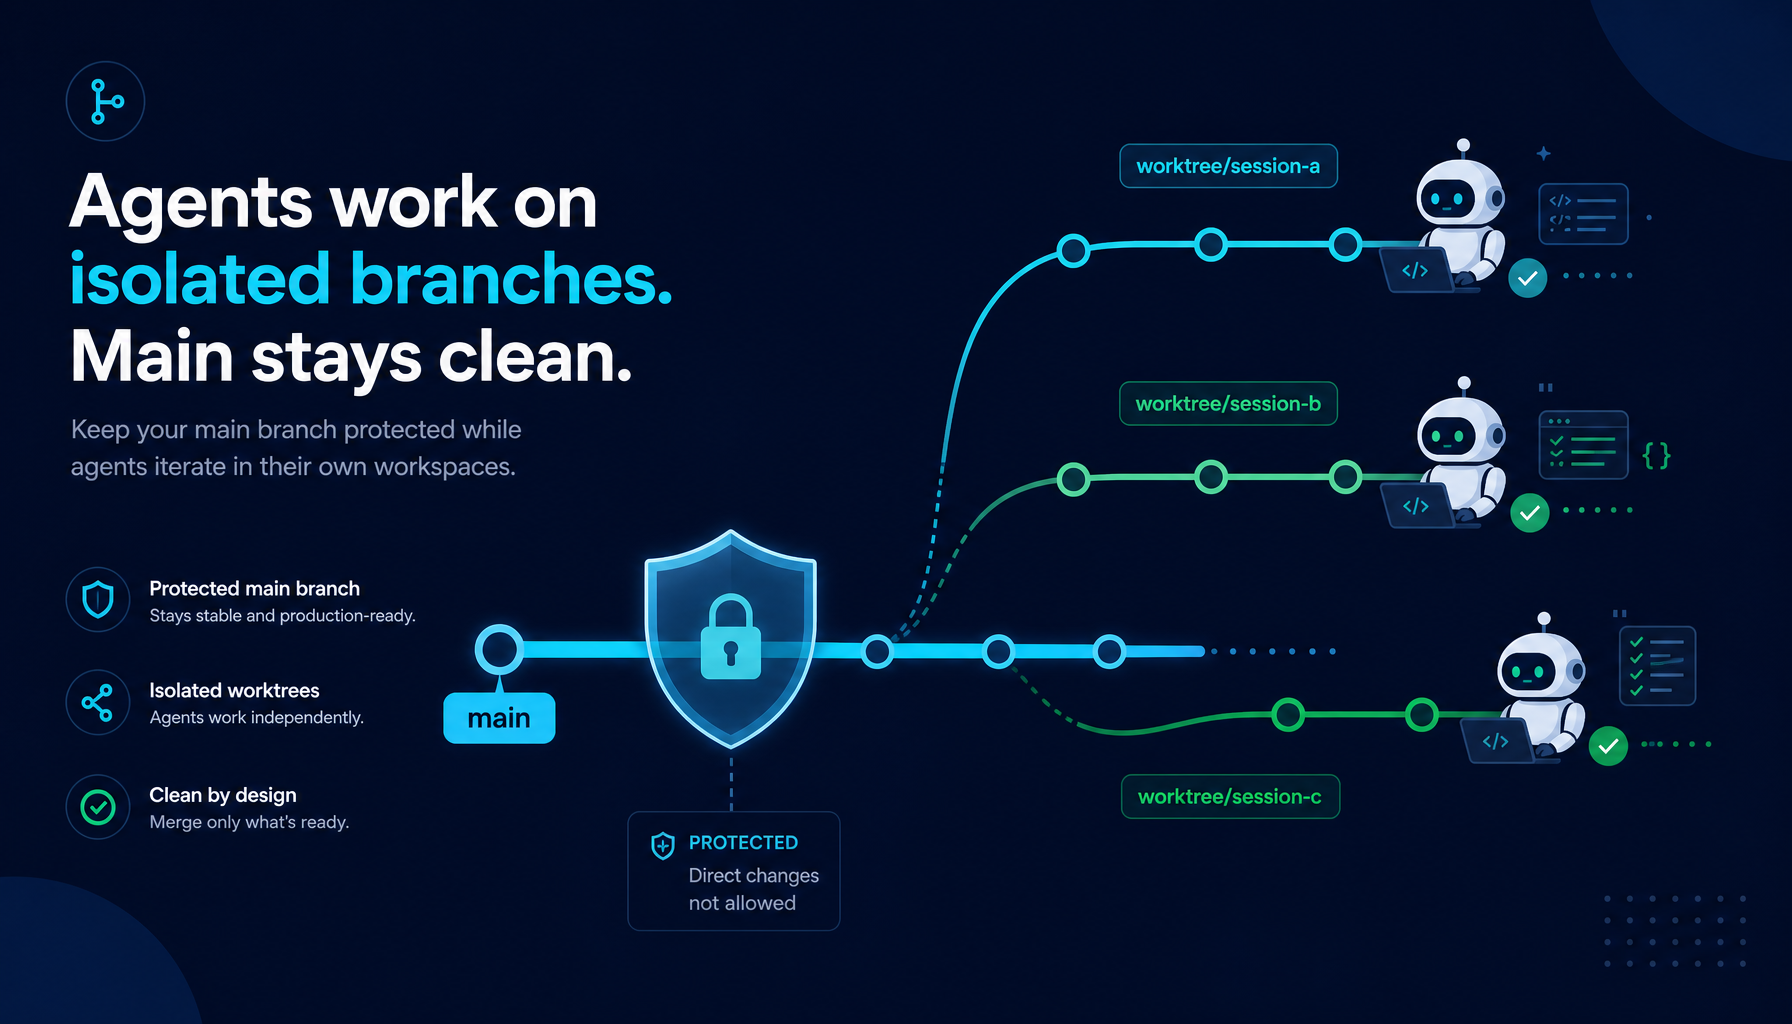
任何编码 Agent 最终都要往你的仓库里写代码。
问题是:它写到哪个分支?

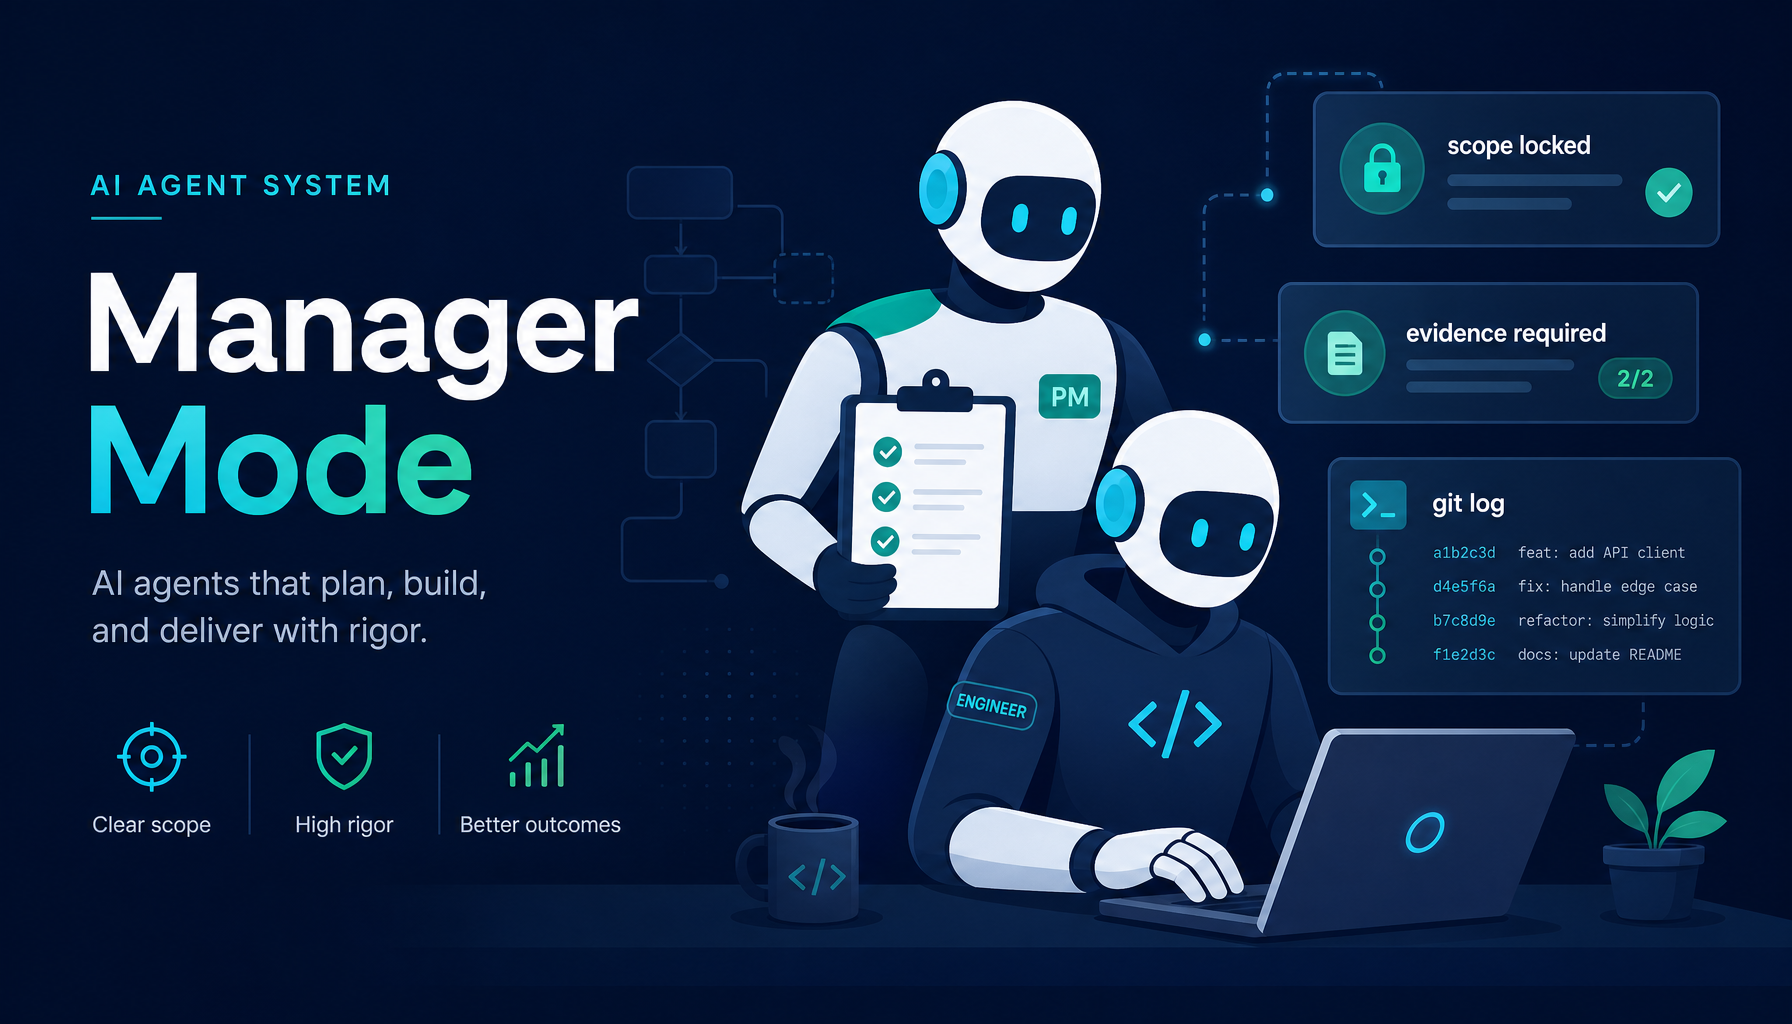
大多数 AI Agent 失败并不是因为能力不足 —— 而是因为它们会偏航。

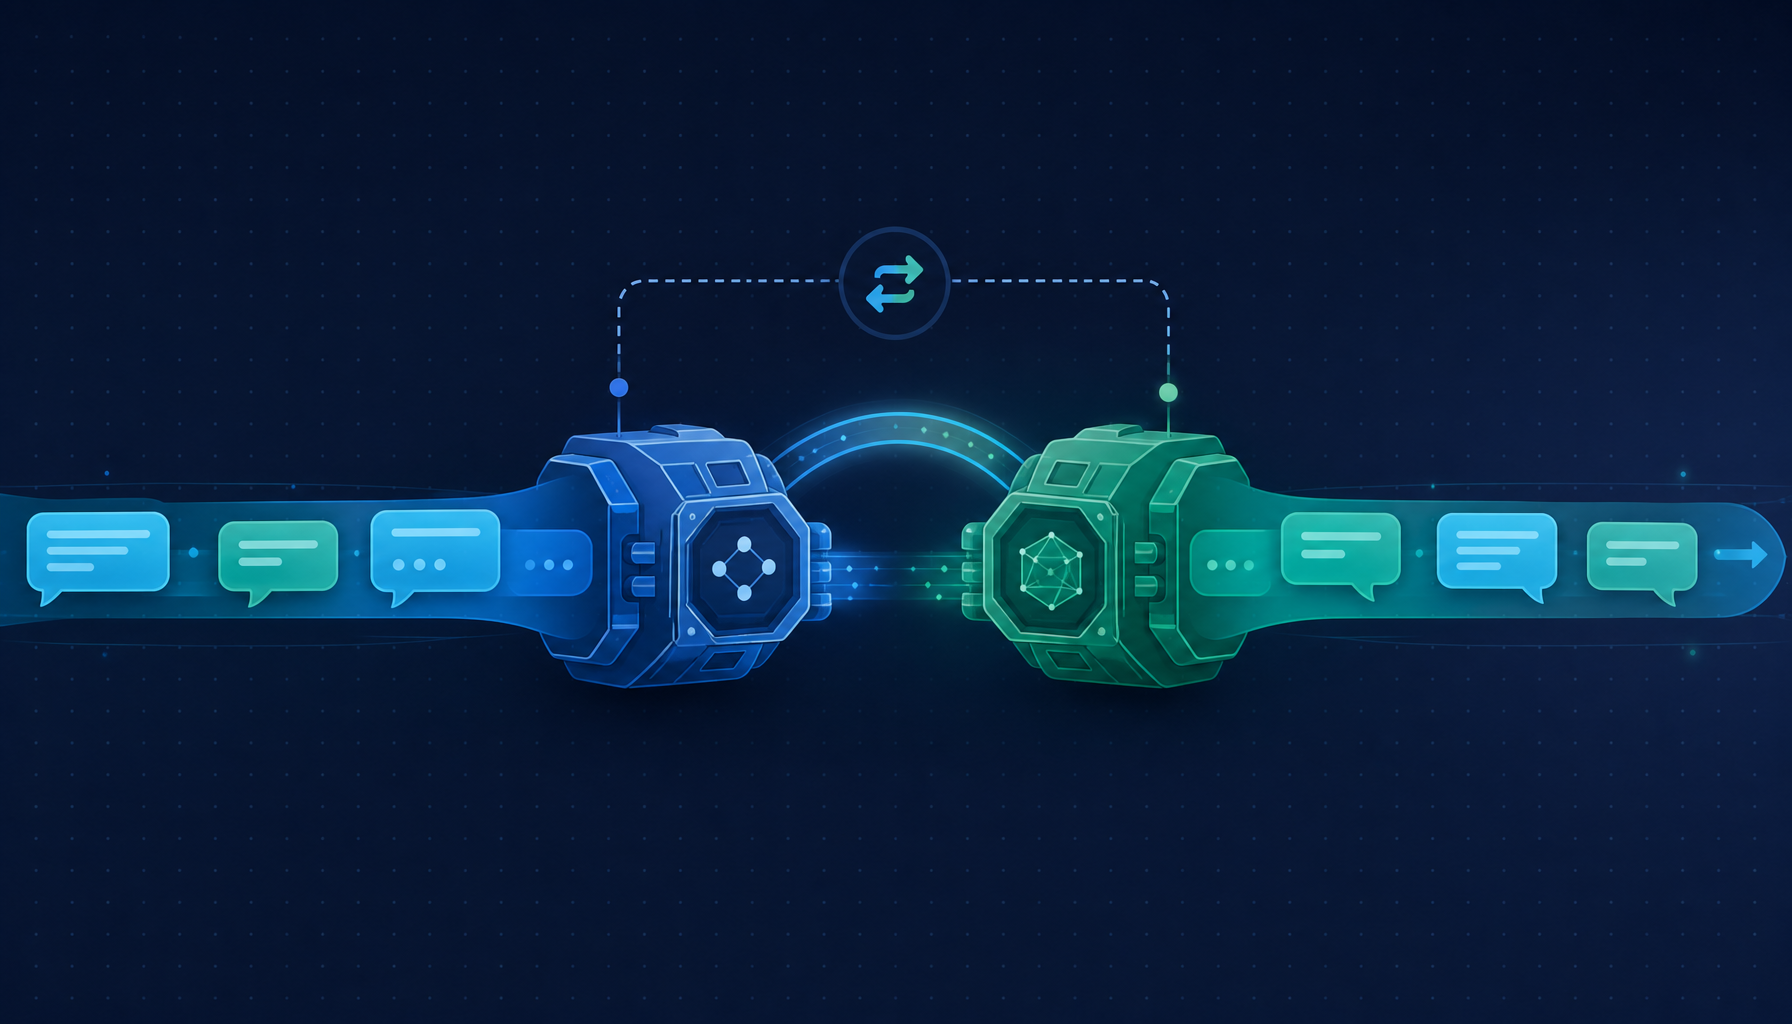
想换一个更便宜的模型?请把需求重新粘贴一遍。
想换一个更强的模型?请把上下文从头讲一遍。
这是大多数 AI 工具今天的现状。

大多数 AI 编码助手在「回答」上越来越聪明,
但在「交付」上几乎没有进步。
这是 Helix 想改变的事。